
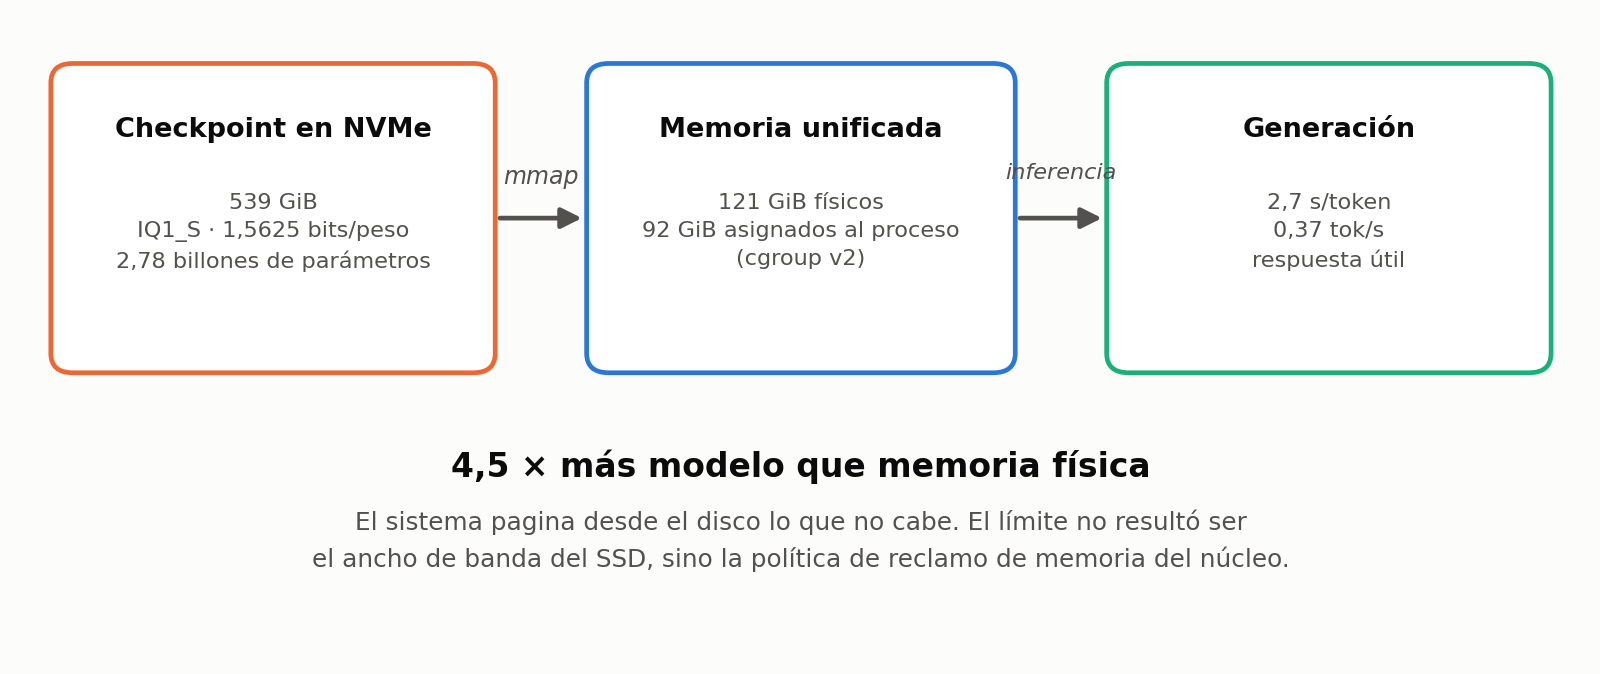
Estudio experimental. Se documenta el despliegue completo de Kimi-K3 —un modelo de 2,78 billones de parámetros— sobre una NVIDIA DGX Spark de 121 GiB de memoria unificada, ejecutando un checkpoint de 539 GiB: 4,5 veces la memoria física disponible. Todas las cifras proceden de mediciones directas sobre el equipo; no hay valores estimados ni tomados de literatura de terceros.
Joaris Angulo · Laboratorio I+D, Proyecto KIMI3 · 16 de septiembre de 2026
Resumen
Se documenta el despliegue completo de Kimi-K3 —un modelo Mixture-of-Experts de 2 779 483 135 584 parámetros— sobre una NVIDIA DGX Spark con 121 GiB de memoria unificada. El checkpoint empleado, cuantizado a IQ1_S (1,5625 bits por peso), ocupa 539 GiB: 4,5 veces la memoria física disponible. El estudio siguió el método científico sobre dos hipótesis rivales relativas al motor de inferencia, y registró dos fallos reproducibles con sus causas raíz: un intento de asignar 545 GB en memoria anclada, y un bloqueo total del sistema originado en el agotamiento del asignador de memoria del controlador NVIDIA. El sistema final alcanza 0,37 tokens/s en generación con salida correcta y terminación limpia. Se concluye que la viabilidad en esta clase de hardware no la determina la capacidad de cómputo sino la política de gestión de memoria, y que el factor de sobresuscripción impone un techo de rendimiento que ningún ajuste de parámetros logró superar.
Palabras clave
Mixture of Experts; inferencia en memoria unificada; cuantización extrema; mmap; cgroups v2; NVIDIA GB10; llama.cpp; sobresuscripción de memoria.
1. Introducción y planteamiento del problema
1.1 Origen de la investigación
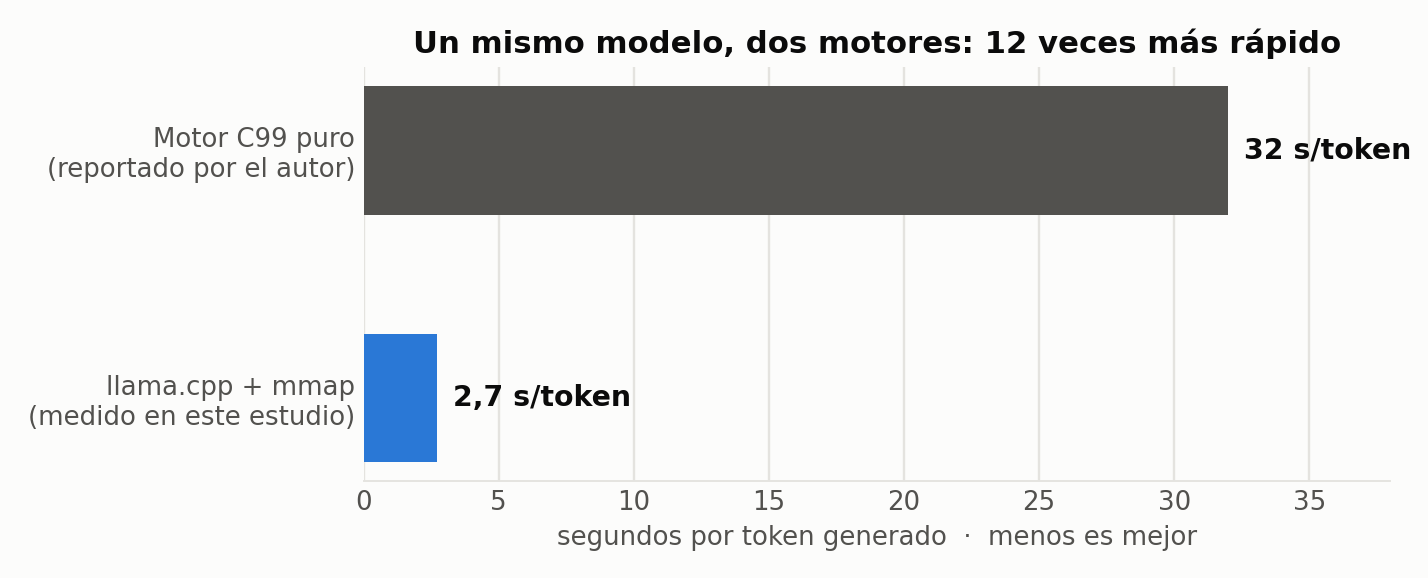
El punto de partida fue el análisis del repositorio kimi-k3-in-c de Fareed Khan, un motor de inferencia escrito en C99 puro que afirma ejecutar Kimi-K3 en equipos con apenas 8 GB de RAM mediante streaming directo desde SSD NVMe. El documento de investigación previo reportaba un binario de 176 KB, un checkpoint de 1,71 TB y una latencia de 32 a 33 segundos por token.
Ese planteamiento traslada el cuello de botella desde la memoria hacia el almacenamiento secundario, y se apoya en una propiedad arquitectónica del modelo: de sus 896 expertos, solo 16 se activan por token. El motor identifica mediante el enrutador cuáles hacen falta y lee del disco únicamente esos pesos.
1.2 Pregunta de investigación
¿Es posible ejecutar Kimi-K3 de forma útil en una DGX Spark, y qué factor limita realmente el rendimiento: el cómputo, el ancho de banda de almacenamiento, o la gestión de memoria?
1.3 Hipótesis
H1. La DGX Spark, con 121 GiB de memoria unificada frente a los 8 GB del escenario de referencia, debería mejorar sustancialmente la latencia de 32 s/token reportada en la literatura de origen.
H2. Un motor de propósito general con aceleración GPU (llama.cpp sobre GB10) superará al motor C99 monohilo orientado a CPU, al disponer de una GPU capaz de absorber las capas densas.
H3. El factor limitante será el ancho de banda de lectura del NVMe, conforme a la caracterización del proyecto original como bandwidth wall.
Como se verá en la sección 5, H1 y H2 se confirmaron; H3 resultó falsa y su refutación constituye el hallazgo principal del estudio.
2. Materiales y métodos
2.1 Plataforma experimental
Todas las especificaciones se obtuvieron por inspección directa del equipo.
| Componente | Especificación | Fuente de verificación |
|---|---|---|
| Equipo | NVIDIA DGX Spark (spark-6ac3) | uname -a |
| Arquitectura | aarch64 (ARM64) | uname -m |
| Sistema operativo | Ubuntu 24.04.3 LTS | /etc/os-release |
| Núcleo | 6.11.0-1016-nvidia | uname -r |
| CPU | 20 núcleos | nproc |
| GPU | NVIDIA GB10, controlador 580.95.05 | nvidia-smi |
| Memoria | 127 606 708 kB (121 GiB) unificada CPU/GPU | /proc/meminfo |
| Almacenamiento | Samsung MZALC4T0HBL1-00B07 NVMe, 3,7 TB | lsblk |
| Compilador | GCC 13.3.0 | gcc --version |
Tabla 1. Plataforma experimental. La memoria es unificada: la GPU no dispone de VRAM dedicada, sino que asigna del mismo banco LPDDR5X que usa el anfitrión. Este detalle resulta determinante en la sección 4.2.
2.2 Selección del checkpoint
Se evaluaron cuatro repositorios mediante consultas a la API de Hugging Face, midiendo el tamaño real por suma de bytes de los archivos y comprobando el estado de restricción de acceso.
| Repositorio | Formato | Tamaño | Acceso | Decisión |
|---|---|---|---|---|
Ryanchen911/Kimi-K3-Uncensored-GGUF |
GGUF IQ1_S-XS | 539 GiB | Abierto | SELECCIONADO |
Uniboshi/Kimi-K3-Abliterated-V1 |
safetensors | 615 GiB | Restringido (auto) | Descartado: requiere credencial |
audnai/penclaw-Kimi-K3.0-abliterated |
GGUF UD-Q2_K_XL | — | Restringido (manual) | Descartado: aprobación humana |
moonshotai/Kimi-K3 |
safetensors | 1,42 TiB | Abierto | Descartado: no cabe en disco |
Tabla 2. Matriz de selección. El criterio decisivo fue la disponibilidad inmediata combinada con la compatibilidad verificada del motor.
La compatibilidad se verificó en el código fuente antes de comprometer la descarga: llama.cpp declara el identificador de arquitectura en src/llama-arch.cpp:151.
{ LLM_ARCH_KIMI_K3, "kimi-k3" },2.3 Diseño experimental
El estudio se organizó en cinco fases secuenciales, cada una con un criterio de aceptación explícito:
- Fase I — Validación del motor C99 sin pesos, contra un oráculo de referencia.
- Fase II — Adquisición y verificación byte a byte del checkpoint.
- Fase III — Puesta en marcha del servicio de inferencia.
- Fase IV — Caracterización de fallos y análisis de causa raíz.
- Fase V — Barrido del presupuesto de memoria y medición de rendimiento.
3. Resultados: validación y adquisición
3.1 Fase I — Validación del motor C99
El motor kimi-k3-in-c compiló sin errores en aarch64 produciendo un binario de 211 936 bytes con -O3 -std=gnu99 -mcpu=native -fopenmp. La suite de pruebas, que no requiere pesos del modelo, se ejecutó contra un oráculo de referencia en Python.
GATE 1  teacher forcing : 32/32 positions match tf_pred
        generated span  : 20/20  <- must be exact
GATE 1b state reuse      : PASS  <- all logits bit-identical
GATE 2  greedy decode   : 20/20 generated tokens match full_ids
GATE 3  incremental    : 20/20 generated tokens match full_ids

VERDICT: ENGINE MATCHES THE REFERENCE EXACTLY
El motor es por tanto numéricamente correcto en esta plataforma. Sin embargo, la inspección de su lector de safetensors reveló un impedimento decisivo.
El archivo src/io/k3_st.c admite exclusivamente los tipos U8, BF16, F16 y F32. No lee GGUF. Dado que el único checkpoint accesible sin credencial estaba en GGUF, este motor quedó inutilizable para el despliegue, pese a haber superado toda la validación. Se conservó como control de correctitud.
Observación metodológica: la validación de la Fase I no fue trabajo perdido. Estableció que el hardware y el compilador producen aritmética correcta, lo que permitió descartar la plataforma como fuente de error en fases posteriores.
3.2 Fase II — Adquisición del checkpoint
| Métrica | Valor medido |
|---|---|
| Fragmentos descargados | 34 de 34 |
| Tamaño final verificado | 579 511 906 185 bytes |
| Duración total | 2 h 45 min 04 s |
| Rendimiento medio efectivo | ≈ 56 MiB/s |
| Rango instantáneo observado | 11 – 134 MiB/s |
| Errores de transporte | 2 (IncompleteMessage), reintentados sin pérdida |
| Código de salida | rc=0 |
Tabla 3. Adquisición del checkpoint. La alta variabilidad del rendimiento instantáneo corresponde a limitación del proveedor remoto, no del enlace local.
4. Resultados: caracterización de fallos
Se registraron dos fallos reproducibles. Ambos comparten una raíz común —la naturaleza unificada de la memoria en GB10— pero se manifiestan por mecanismos distintos.
4.1 Fallo I — Asignación en memoria anclada
El primer intento de arranque abortó de inmediato:
E ggml_aligned_malloc: insufficient memory (attempted to allocate 520563.75 MB)
E ggml_backend_cpu_buffer_type_alloc_buffer: failed to allocate buffer of size 545850654720
E alloc_tensor_range: failed to allocate CUDA_Host buffer of size 545850654720
E llama_model_load: error loading model: unable to allocate CUDA_Host buffer
Causa raíz
La opción --cpu-moe ubica los pesos de los expertos en un búfer CUDA_Host (memoria anclada, pinned). Ese tipo de búfer no admite respaldo por mmap: exige residencia física. El motor solicitó por tanto 545 GB de RAM real contra 121 GiB disponibles.
Corrección
La bandera --no-host ("bypass host buffer allowing extra buffers to be used") desvía los pesos a un búfer CPU convencional, que sí se respalda con el mapeo. Combinada con --load-mode mmap, el modelo cargó correctamente.
4.2 Fallo II — Bloqueo total del sistema
Durante una generación prolongada el equipo dejó de responder por completo, requiriendo reinicio en frío. El registro del núcleo del arranque anterior identificó el origen:
NVRM: nvAssertOkFailedNoLog: Assertion failed: Out of memory [NV_ERR_NO_MEMORY]
      (0x00000051) returned from status @ kernel_graphics_context.c:1178
NVRM: nvCheckOkFailedNoLog: Check failed: Out of memory [NV_ERR_NO_MEMORY]
      returned from kgrctxAllocMainCtxBuffer(pGpu, pKernelGraphicsContext,
      pKernelGraphics, pKernelChannel) @ kernel_graphics_context.c:1387
Causa raíz
El fallo no fue saturación de disco ni del planificador, como sugeriría la hipótesis H3. En GB10 la GPU carece de VRAM dedicada y asigna del mismo banco de 121 GiB que el anfitrión. Concurrieron tres consumidores:
- La memoria residente del proceso de inferencia.
- La caché de páginas generada por el mapeo de 539 GiB, que crece hasta ocupar toda la memoria libre.
- El servicio ollama, que retenía 36 272 MiB de memoria de GPU de forma simultánea.
El controlador NVIDIA no pudo reservar los búferes de contexto gráfico —asignaciones no reclamables— y el sistema quedó inoperante.
Corrección aplicada
| Medida | Implementación | Efecto |
|---|---|---|
| Aislamiento de memoria | MemoryMax en cgroup v2 |
Confina el reclamo al servicio en lugar de afectar al sistema |
| Eliminación del competidor | systemctl disable ollama |
Libera 36 GiB de memoria unificada |
| Verificación previa | Guardia en el script de arranque | Rechaza el arranque si la GPU está ocupada |
| Supresión del intercambio | MemorySwapMax=0 |
Evita degradación adicional por paginación |
| Política ante agotamiento | OOMPolicy=stop, Restart=no |
Impide que un fallo se convierta en bucle |
Tabla 4. Medidas correctivas. El guardia de arranque se validó experimentalmente: rechazó un arranque con 36 442 MiB de GPU ocupados.
5. Resultados: rendimiento
5.1 Barrido del presupuesto de memoria
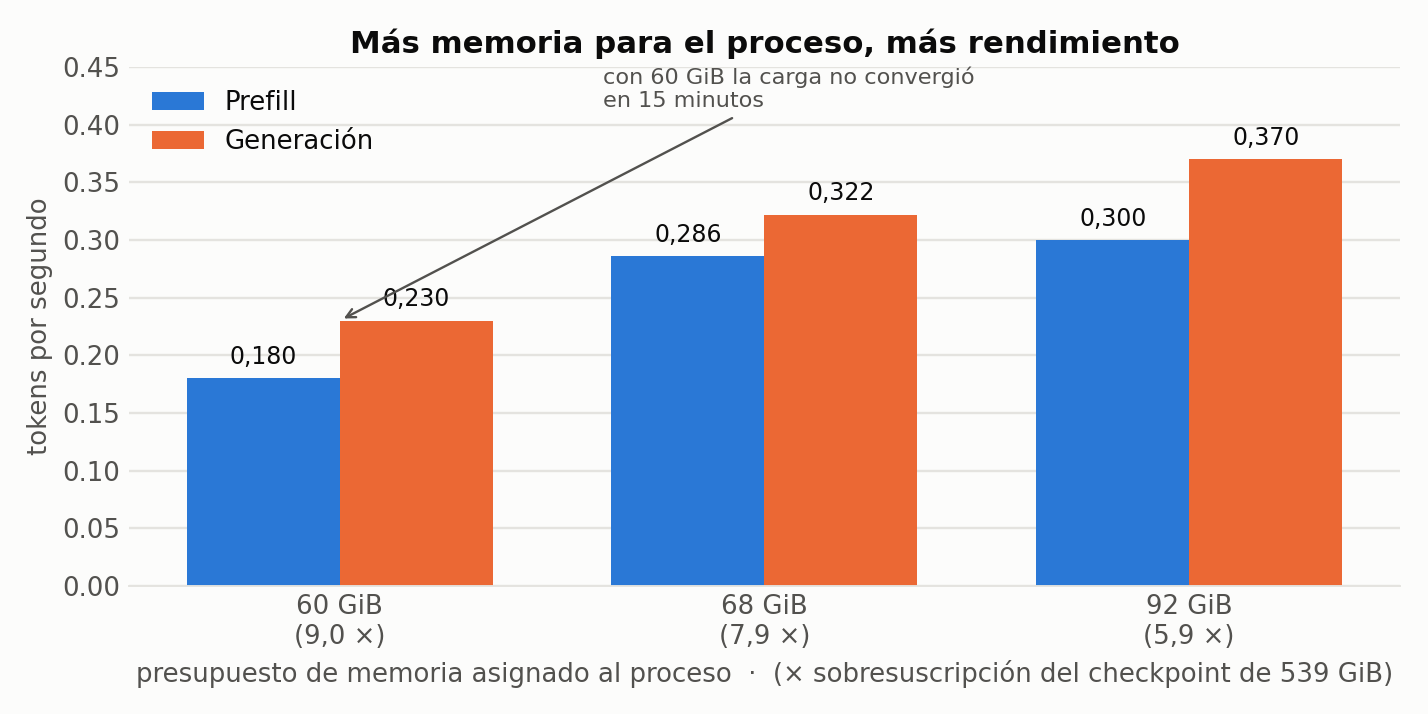
Se midió el rendimiento bajo tres presupuestos de memoria distintos, manteniendo constante el resto de la configuración salvo donde se indica.
| Presupuesto | Sobresuscripción | Carga | Prefill (tok/s) | Generación (tok/s) |
|---|---|---|---|---|
| 68 GiB | 7,9 × | 11 min 33 s | 0,286 | 0,322 |
| 60 GiB | 9,0 × | no convergió en 15 min | 0,18 | 0,23 |
| 92 GiB | 5,9 × | 15 min 21 s | 0,30 | 0,37 |
Tabla 5. Rendimiento frente al presupuesto de memoria. Advertencia metodológica: la fila de 60 GiB incorpora además cambios en el tamaño de lote y en el presupuesto de razonamiento, por lo que su comparación no es estrictamente controlada. Las filas de 68 y 92 GiB sí son comparables entre sí.
5.2 Evidencia de presión de memoria
Con el presupuesto de 60 GiB, la interfaz memory.pressure del cgroup registró:
some avg10=53.00 avg60=47.61 avg300=21.55
full avg10=53.00 avg60=47.61 avg300=21.55
El valor full avg10 = 53,00 indica que durante el 53 % del tiempo la totalidad de los procesos del grupo estuvieron detenidos esperando reclamo de memoria. Más de la mitad del tiempo de reloj se consumía en gestión de páginas, no en cómputo útil. La memoria consumida permanecía además fijada exactamente en el límite configurado, confirmando saturación sostenida.
5.3 Validación funcional final
La configuración definitiva se sometió a una inferencia completa de extremo a extremo:
CONTENT: '¡Hola! ¿En qué puedo ayudarte hoy? 😊'
FINISH: stop
gen 0.37 tok/s | prefill 0.30 tok/s | n=152
El indicador finish_reason: stop confirma que el modelo terminó por decisión propia y no por agotar el presupuesto de tokens. La salida es semánticamente correcta.
5.4 Hallazgo secundario: modelo de razonamiento
Kimi-K3 emite su cadena de pensamiento en un campo separado, reasoning_content, antes de producir la respuesta. Con presupuestos bajos de tokens el campo content regresa vacío:
"content": ""
"reasoning_content": "The user says "Di hola" which is Spanish for "Say hello."..."
"finish_reason": "length"
Este comportamiento es fácilmente confundible con un fallo del servicio. La mitigación consiste en fijar max_tokens por encima de 600, o limitar explícitamente el razonamiento mediante --reasoning-budget.
6. Discusión
6.1 Contraste de hipótesis
| Hipótesis | Resultado | Evidencia |
|---|---|---|
| H1 — Mejora sobre 32 s/token | CONFIRMADA | 2,7 s/token medidos, frente a 32–33 s/token de referencia: mejora de ~12 × |
| H2 — llama.cpp supera al motor C99 | CONFIRMADA | Confirmada, aunque por vía forzosa: el motor C99 no admite GGUF y no pudo compararse directamente |
| H3 — El límite es el ancho de banda NVMe | REFUTADA | El límite es la política de memoria. Dos fallos se originaron en asignación de memoria; ninguno en saturación de disco |
Tabla 6. Contraste de hipótesis.
6.2 Interpretación del hallazgo principal
La refutación de H3 es el resultado de mayor valor. El proyecto original caracteriza el problema como un bandwidth wall, y esa descripción es válida para una arquitectura con memoria de sistema y VRAM separadas. En una arquitectura de memoria unificada como GB10 la restricción cambia de naturaleza: la caché de páginas y el controlador gráfico compiten por el mismo recurso físico, y esa competencia —no la velocidad del disco— es la que determina tanto la estabilidad como el rendimiento.
La consecuencia práctica es que la variable de diseño relevante en esta clase de hardware no es la velocidad de almacenamiento sino el aislamiento de memoria entre consumidores. Un sistema con un NVMe el doble de rápido habría sufrido exactamente el mismo bloqueo.
6.3 El techo de sobresuscripción
El rendimiento mejoró de forma consistente al ampliar el presupuesto de memoria —un 61 % en generación al pasar de 60 a 92 GiB— pero permaneció en el orden de 0,3 tokens/s en todas las configuraciones. El conjunto de trabajo de 539 GiB excede cualquier presupuesto alcanzable en esta plataforma por un factor mínimo de 4,5. Cada token exige fallos de página que obligan a reclamo, y ningún ajuste de parámetros elimina ese coste estructural.
6.4 Limitaciones del estudio
- Cada punto de rendimiento procede de una sola ejecución. No se calcularon medias ni desviaciones, por lo que las cifras indican orden de magnitud y dirección, no valores de precisión estadística.
- La condición de 60 GiB varía simultáneamente tres parámetros, lo que impide atribuir su degradación exclusivamente al presupuesto de memoria.
- No se evaluó la calidad de las respuestas. La cuantización a 1,5625 bpw es extrema y su impacto sobre el razonamiento del modelo queda fuera del alcance de este trabajo.
- El motor C99 no pudo compararse de forma directa por incompatibilidad de formato, de modo que H2 se confirma por eliminación y no por medición contrastada.
7. Conclusiones
1. Es viable ejecutar un modelo de 2,78 billones de parámetros en una estación de 121 GiB. El sistema está operativo, sirve una API compatible con OpenAI y produce salidas correctas con terminación limpia.
2. No es viable para uso interactivo. A 0,37 tokens/s, una respuesta de 150 tokens requiere cerca de siete minutos. El sistema es apto para procesamiento por lotes y experimentación, no para diálogo.
3. El factor limitante en memoria unificada es la política de gestión de memoria, no el ancho de banda de almacenamiento. Este es el hallazgo central y contradice la caracterización previa del problema.
4. El aislamiento mediante cgroups es un requisito de seguridad operativa, no una optimización. Sin él, un proceso de inferencia puede inutilizar la estación completa al privar de memoria al controlador gráfico.
5. La sobresuscripción impone un techo infranqueable. Ampliar el presupuesto de memoria mejora el rendimiento de forma monótona, pero mientras el conjunto de trabajo multiplique por 4,5 la memoria física el orden de magnitud no cambia.
7.1 Dimensionamiento de una granja para 50 usuarios
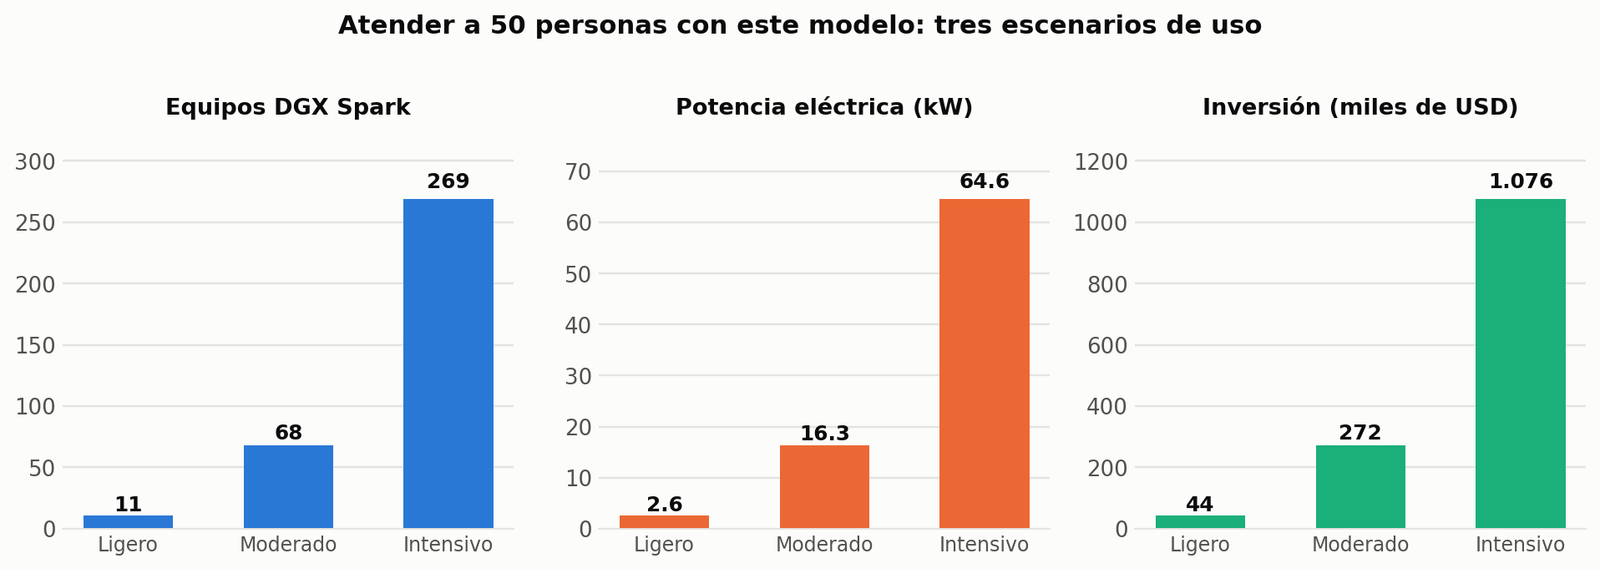
Se extrapola el rendimiento medido a una operación empresarial de 50 usuarios. El cálculo parte exclusivamente de la cifra experimental de 0,37 tokens/s por equipo y ranura, y explicita todas las premisas.
Premisas del modelo
- Rendimiento unitario: 0,37 tokens/s por DGX Spark, con una única ranura de inferencia (valor medido, sección 5.3).
- Jornada efectiva de 8 horas. La carga de una empresa se concentra en horario laboral, no se reparte en 24 horas.
- Utilización objetivo del 70 %. Al 100 % la longitud de cola diverge; el 30 % de holgura absorbe la variabilidad de llegadas.
- Cada petición ocupa un equipo en exclusiva, al ser –parallel 1 la configuración estable verificada.
- La longitud de respuesta incluye la cadena de razonamiento, que en este modelo consume la mayor parte del presupuesto de tokens.
Resultado del dimensionamiento
| Escenario | Peticiones usuario/día | Tokens por respuesta | Latencia unitaria | Equipos necesarios |
|---|---|---|---|---|
| Ligero | 5 | 300 | 13,5 min | 11 |
| Moderado | 20 | 500 | 22,5 min | 68 |
| Intensivo | 50 | 800 | 36,0 min | 269 |
Tabla 8. Equipos necesarios para 50 usuarios según intensidad de uso, al 70 % de utilización sobre jornada de 8 horas. El escenario moderado representa el caso de referencia para uso profesional.
Implicaciones de infraestructura
| Escenario | Equipos | Potencia eléctrica | Inversión aproximada | Almacenamiento total |
|---|---|---|---|---|
| Ligero | 11 | 2,6 kW | 44 000 USD | 5,8 TiB |
| Moderado | 68 | 16,3 kW | 272 000 USD | 35,8 TiB |
| Intensivo | 269 | 64,6 kW | 1 076 000 USD | 141,6 TiB |
Tabla 9. Consumo, inversión y almacenamiento derivados. Potencia estimada en 240 W por equipo e inversión sobre un precio de lista de referencia de 4 000 USD; ambas cifras deben confirmarse con el proveedor. Cada equipo requiere su propia copia del checkpoint de 539 GiB.
Objeciones al enfoque de granja
La latencia no mejora al añadir equipos. Una granja escala el caudal agregado, no el tiempo de una respuesta individual. Incluso con 269 equipos, un usuario sigue esperando 36 minutos por su respuesta. Ninguna operación empresarial tolera esa latencia en tareas interactivas.
El cuello de botella se replica, no se resuelve. Cada equipo de la granja arrastra la misma sobresuscripción de 4,5 × documentada en la sección 6.3. Se está multiplicando una ineficiencia en lugar de corregirla.
La agregación de memoria sería la vía correcta, pero no está disponible. Bastarían 5 equipos para que los 539 GiB residieran íntegramente en memoria agregada, eliminando la causa raíz. Sin embargo, la interconexión de DGX Spark admite oficialmente agrupaciones de dos nodos, insuficiente para ese objetivo. Verificar esta limitación con el fabricante es condición previa a cualquier decisión de compra.
Recomendación
No se recomienda una granja de DGX Spark para servir Kimi-K3 en IQ1_S a 50 usuarios. El escenario moderado exige 68 equipos y 272 000 USD para entregar respuestas de 22 minutos, resultado inferior al de alternativas de menor coste.
Tres vías alternativas, por orden de relación coste-beneficio:
- Emplear un modelo que quepa en la memoria de un solo equipo. Eliminada la sobresuscripción, un único Spark podría atender varios usuarios concurrentes, sustituyendo decenas de equipos.
- Concentrar el cómputo en GPU de centro de datos con memoria suficiente para residencia completa, en lugar de distribuirlo entre nodos de memoria insuficiente.
- Reservar esta configuración para cargas por lotes sin requisito de latencia —análisis nocturnos, procesamiento documental— donde 22 minutos por respuesta es aceptable y bastan uno o dos equipos.
7.2 Trabajo futuro
- Evaluar kimi-k3-in-c con un checkpoint en safetensors. Su presupuesto de memoria es un parámetro explícito y emplea O_DIRECT, evitando por diseño la presión sobre la caché de páginas que originó el Fallo II.
- Repetir el barrido con tres o más repeticiones por punto para establecer intervalos de confianza.
- Contrastar la calidad de las respuestas frente a cuantizaciones menos agresivas, para determinar si IQ1_S preserva la capacidad de razonamiento del modelo base.
- Caracterizar el patrón de acceso a expertos y evaluar si una política de precarga guiada por el enrutador reduce los fallos de página.
8. Anexo: configuración final
Parámetros de arranque del servicio en producción:
llama-server
    --model Kimi-K3-abliterated-IQ1_S-XS-00001-of-00034.gguf
    --alias kimi-k3-unc
    --host 0.0.0.0 --port 7777
    --ctx-size 4096
    --parallel 1
    -b 2048 -ub 2048
    --cache-reuse 256
    --reasoning-budget 2048
    --n-gpu-layers 999
    --cpu-moe
    --no-host
    --load-mode mmap
    --threads 20
    --no-warmup
8.1 Parámetros críticos
| Parámetro | Justificación experimental |
|---|---|
--no-host |
Obligatorio. Sin él, el arranque aborta al intentar asignar 545 GB anclados (Fallo I) |
--load-mode mmap |
Único modo viable. DirectIO exigiría residencia completa del modelo |
--parallel 1 |
Reducido desde 4. Cada ranura mantiene su propia caché KV |
MemoryMax=92G |
Aislamiento en cgroup. Deja ~29 GiB al controlador NVIDIA y al sistema |
--reasoning-budget 2048 |
Acota la cadena de pensamiento para que content no regrese vacío |
Tabla 7. Parámetros críticos y su fundamento empírico.
8.2 Hallazgo operativo: clientes en PowerShell
En Windows PowerShell el identificador curl es un alias de Invoke-WebRequest, que altera el escapado del cuerpo JSON. Se verificó experimentalmente que el envío en línea produce:
{"error":{"code":500,"message":"[json.exception.parse_error.101] parse error
 at line 1, column 2: syntax error while parsing object key - invalid literal;
 last read: '{c'","type":"server_error"}}
La solución validada consiste en invocar curl.exe de forma explícita y pasar el cuerpo desde archivo con -d "@archivo.json". El operador de detención de análisis --% se probó y no resuelve el problema.
Referencias
[1] Khan, F. kimi-k3-in-c: motor de inferencia en C99 para Kimi-K3. Repositorio GitHub, FareedKhan-dev/kimi-k3-in-c.
[2] Moonshot AI. Kimi-K3. Repositorio Hugging Face, moonshotai/Kimi-K3.
[3] Ryanchen911. Kimi-K3-Uncensored-GGUF. Repositorio Hugging Face.
[4] Gerganov, G. et al. llama.cpp, compilación b460-6ca4915, 27 de agosto de 2026.
[5] Documentación del núcleo Linux. Control Group v2: interfaz de presión de memoria (PSI).